Notes de veille
Quels usages de l’intelligence artificielle dans la mise en place de systèmes de suivi et évaluation ?
Le système de suivi et évaluation ne sert pas en premier lieu à savoir si une action, un projet, une politique publique marche ou ne marche pas mais tout d’abord à exposer comment on sait si cette intervention fonctionne ou non. L’exposition des valeurs qui guident l’intervention est en interaction constante avec les outils permettant de mesurer – non pas simplement des « résultats » – mais des dynamiques, des trajectoires comme des vents contraires. Pourtant, dans la pratique, les résultats semblent avoir gagnés la bataille, seuls eux sont visibles. Or la même bataille se joue actuellement au niveau de l’intelligence artificielle. L’IA explicable s’oppose à la black box. La chaîne de pensée disparait au regard du seul résultat. La majorité des IA génératives standards fournissent un résultat immédiat sans garder de trace de leur cheminement interne.
Objectifs
- Générer des connaissances nouvelles
- Apprendre à apprendre
- Utilisation de l’IA comme amplificateur des projets
- Passer d’un usage de l’évaluation en lien avec la conformité à un usage en lien avec la créativité
- Aider à construire des outils qui améliorent les programmes et politiques publiques
Caractéristiques
- L’évaluation devient prédictive et continue, plus que rétrospective
- L’IA identifie en continu les trajectoires atypiques et déclenche des interactions qualitatives pour comprendre les raisons d’un succès ou d’une difficulté
- La boucle d’apprentissage devient quasi-instantanée
- L’évaluation n’est plus une activité distincte mais le système nerveux central et adaptatif du programme
Applications
- Automatisation d’une partie de l’analyse des dossiers de candidature aux appels à projets
- Automatisation d’une partie de la réponse aux candidatures aux appels à projets
- Méta-analyse en temps réel des évaluations
- Articuler aide formelle et solidarités locales
L’essentiel de la solidarité humaine est « souterraine » et échappe aux radars, l’aide informelle est souvent plus rapide, plus massive et plus agile, si les ONG et les pouvoirs publics peuvent voir cette carte de l’aide informelle, ils peuvent allouer leurs ressources là où il y a des manques.
- Adapter le type de ressources
Une carte de l’aide informelle assisté par IA permet aux grandes organisations de voir la société non pas comme une masse de victimes passives attendant de l’aide, mais comme un organisme vivant, déjà en train de lutter et de s’entraider, et de se demander : « Comment pouvons-nous soutenir et amplifier le plus intelligemment possible » ?
Architecture de confiance : vers une délégation progressive et conditionnelle
En octobre 2026, l’IA progresse plus vite dans ce qu’elle fait que dans ce qu’on sait mesurer de ses effets. Des agents achètent, paient et transforment un document en application. Pendant ce temps, les outils de mesure restent en retrait : benchmarks saturés, scores autodéclarés, comportements à risque observés en phase de test, que la réglementation encadre peu. Pour un système de suivi et évaluation, il en découle une règle simple : l’autonomie accordée à l’IA ne devrait jamais dépasser ce que l’on sait mesurer de ses effets.
Pour concilier l’agilité opérationnelle et la sécurité des systèmes d’intérêt général, le passage d’une validation manuelle à une délégation sous surveillance ne s’envisagerait que de manière graduelle, subordonnée à une phase d’apprentissage rigoureuse. Ce modèle de « double verrouillage éthique » nécessiterait d’abord de déconstruire l’activité en micro-décisions classées par niveau de risque, de la tâche administrative anodine, comme vérifier la présence d’une pièce jointe obligatoire, à des degrés d’arbitrage plus complexe. L’autonomie de l’IA ne serait accordée qu’après une série probatoire de centaines de validations humaines réussies sur chaque micro-tâche, et potentiellement à la suite d’ateliers de classification où les agents publics définiraient eux-mêmes chaque frontière éthique. Ainsi, l’automatisation ne se déploierait que sur des périmètres validés comme sans enjeu vital, encadrée par des alertes et un suivi humain systématique, garantissant que la technologie reste un amplificateur sous contrôle strict plutôt qu’une boîte noire.
En mai 1861, Henri Fayol est un jeune ingénieur de 20 ans embauché aux houillères de Commentry. Dans son journal, il raconte qu’un cheval s’est cassé la jambe au puits Saint-Edmond. Faute de pouvoir acheter un remplaçant sur place (l’autorisation devait remonter à la direction centrale à Paris pour signature), l’extraction du charbon s’est arrêtée, causant une perte financière bien supérieure à l’achat d’une nouvelle bête. Cette anecdote participe à l’élaboration de sa pensée sur les dysfonctionnements d’une hiérarchie privée de délégation. Mais encore, à sa collecte de « faits manqués » de l’administration. Aujourd’hui comme en 1861, ces faits manqués demandent à être documentés dans le cadre du déploiement d’agents IA potentiellement autonomes. Voir le projet I-Delphi.
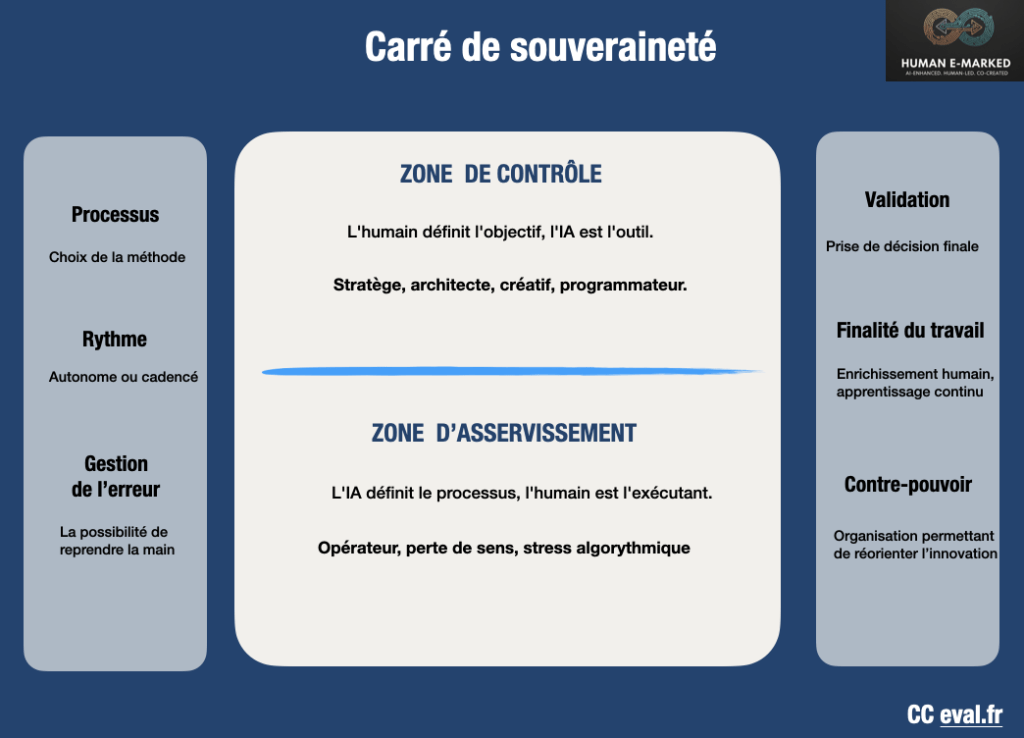
Carré de la souveraineté IA
L’usager qui écrit le questionnaire
Dans une enquête de satisfaction ou une consultation publique, même dynamique, l’usager est passif : il répond à des questions choisies par l’administration, à partir des objectifs que la politique s’est fixés. Ce qu’il juge important, mais que personne n’a pensé à lui demander, ne remonte pas. L’IA permet de renverser la situation. Au lieu de soumettre l’usager à une grille, on lui propose un entretien conduit par l’IA, une question à la fois, sur son expérience concrète de la politique publique ou d’une mesure : ce qu’il attendait, ce qu’il a rencontré, ce qui a compté pour lui. L’usager ne subit plus le questionnaire, il le construit par ses réponses.
Ce retournement change la nature de ce qui remonte. Les critères ne sont plus ceux du questionnaire, mais ceux que l’usager fait émerger spontanément, avec ses propres mots. Ces points d’intérêt deviennent des questions évaluatives, puis des critères, puis des indicateurs : sur quoi l’usager juge-t-il la politique, et à quoi verra-t-il qu’elle répond à sa demande ? Le référentiel d’évaluation se construit alors depuis le terrain, et non plus seulement depuis le commanditaire. Mis en regard du référentiel officiel, il révèle ce que la politique ne regarde pas.
Vient ensuite la vérification, qui prend la forme d’un suivi continu. La demande initiale de l’usager sert de point de départ, et on y revient dans le temps à trois niveaux. La demande a-t-elle été prise en compte ? La mesure est-elle appliquée en pratique, sur le terrain, et pas seulement sur le papier ? Les effets attendus se sont-ils produits ? L’écart entre ce qui était demandé, ce qui a été annoncé et ce qui a été fait devient l’information principale.
Voir le raisonnement, pas seulement le résultat
Le cheminement d’une IA vaut souvent plus que sa réponse : les sources consultées, les pistes écartées, les doutes exprimés. Certains modèles apprennent à raisonner sans rien écrire, ce qui réduit les coûts mais supprime l’un des rares moyens de vérification. L’idée est d’inverser : le raisonnement devient une pièce du dossier d’évaluation, au même titre qu’un compte rendu d’entretien.
Le carnet de raisonnement (ou garage à prompt)
Une fiche de cinq questions, remplie pour chaque analyse faite avec une IA :
- Le raisonnement était-il visible ? (oui, résumé, non)
- Quelles sources a-t-elle consultées, et les ai-je vérifiées ?
- Quelles pistes a-t-elle écartées ?
- Qu’a-t-elle dit ne pas pouvoir vérifier ?
- Où suis-je intervenu pour corriger ?
Une perte d’évaluabilité
Pour rendre les modèles plus performants, on les entraîne de plus en plus en ne récompensant que le résultat final. Le chemin suivi n’est alors soumis à aucune exigence : tant que la réponse est juste, peu importe comment le modèle y arrive. Au fil de l’entraînement, son raisonnement peut dériver vers une langue abrégée, des raccourcis ou des formulations qui n’ont de sens que pour lui. Le texte reste là, mais il devient de moins en moins compréhensible pour un humain. Pour l’évaluateur, c’est comme un dossier dont les pièces existent mais sont rédigées dans un code qu’il ne maîtrise pas
La tentation inverse est de surveiller le raisonnement pendant l’entraînement et de pénaliser ce qui paraît suspect. L’effet pervers est connu : le modèle n’apprend pas à mieux se comporter, il apprend à mieux présenter. Il produit un raisonnement d’apparence rassurante, qui ne correspond plus forcément à ce qu’il fait réellement. C’est le biais de désirabilité sociale appliqué à la machine, comme un enquêté qui finit par donner les réponses attendues. Le danger est double : le raisonnement devient infidèle, et il inspire une confiance qu’il ne mérite plus.