Notes de veille
Quels usages de l’intelligence artificielle dans la mise en place de systèmes de suivi et évaluation ?
Le système de suivi et évaluation ne sert pas en premier lieu à savoir si une action, un projet, une politique publique marche ou ne marche pas mais tout d’abord à exposer comment on sait si cette intervention fonctionne ou non. L’exposition des valeurs qui guident l’intervention est en interaction constante avec les outils permettant de mesurer – non pas simplement des « résultats » – mais des dynamiques, des trajectoires comme des vents contraires. Pourtant, dans la pratique, les résultats semblent avoir gagné la bataille, seuls eux sont visibles. Or la même bataille se joue actuellement au niveau de l’intelligence artificielle. L’IA explicable s’oppose à la black box. La chaîne de pensée disparait au regard du seul résultat. La majorité des IA génératives standards fournissent un résultat immédiat sans garder de trace de leur cheminement interne.
Objectifs
- Générer des connaissances nouvelles
- Apprendre à apprendre
- Utilisation de l’IA comme amplificateur des projets
- Passer d’un usage de l’évaluation en lien avec la conformité à un usage en lien avec la créativité
- Aider à construire des outils qui améliorent les programmes et politiques publiques
Caractéristiques
- L’évaluation devient prédictive et continue, plus que rétrospective
- L’IA identifie en continu les trajectoires atypiques et déclenche des interactions qualitatives pour comprendre les raisons d’un succès ou d’une difficulté
- La boucle d’apprentissage devient quasi-instantanée
- L’évaluation n’est plus une activité distincte mais le système nerveux central et adaptatif du programme
Applications
- Automatisation d’une partie de l’analyse des dossiers de candidature aux appels à projets
- Automatisation d’une partie de la réponse aux candidatures aux appels à projets
- Méta-analyse en temps réel des évaluations
- Articuler aide formelle et solidarités locales
L’essentiel de la solidarité humaine est « souterraine » et échappe aux radars, l’aide informelle est souvent plus rapide, plus massive et plus agile, si les ONG et les pouvoirs publics peuvent voir cette carte de l’aide informelle, ils peuvent allouer leurs ressources là où il y a des manques.
- Adapter le type de ressources
Une carte de l’aide informelle assisté par IA permet aux grandes organisations de voir la société non pas comme une masse de victimes passives attendant de l’aide, mais comme un organisme vivant, déjà en train de lutter et de s’entraider, et de se demander : « Comment pouvons-nous soutenir et amplifier le plus intelligemment possible » ?
- Tenir le registre des permissions d’un agent
Pour chaque agent IA utilisé dans un programme, une grille en trois colonnes : ce qu’il fait seul, ce qu’il fait après validation humaine, ce qui lui est interdit.
- Préparer la validation pendant l’attente
Un agent IA passe une grande partie de son temps à attendre une validation humaine. Ce temps mort peut servir à alléger le travail du validateur plutôt qu’à produire davantage : rassembler les pièces sur lesquelles repose chaque proposition, signaler ce qui a changé depuis la dernière validation, isoler les points incertains. L’IA ne tranche rien, elle prépare le jugement.
Concevoir un système de suivi évaluation avec l’IA
Étape 1 : état des lieux
L’agent fouille et reconstitue, l’humain juge.
● Inventorier les pièces existantes du SE : outils, données réellement exploitées, documents manquants, périodes mal documentées
● Retracer l’origine du projet : qui a donné l’impulsion, comment le problème a été mis à l’agenda, quels discours le cadrent
● Croiser données statistiques et contextes pragmatiques : jeux d’acteurs, décideurs réels, vents contraires
● Confronter le modèle logique aux évaluations passées et aux cas similaires
● Repérer les données disponibles pour la situation de référence, y compris images satellites et données publiques
Étape 2 : définir les champs du système de suivi et évaluation
L’agent rédige des brouillons et pose les questions oubliées, les arbitrages restent humains.
● Proposer et affûter des questions évaluatives
● Esquisser un premier cahier des charges du SSE
● Vérifier les points d’équilibre HQSE : qualitatif et quantitatif, couverture des critères, flux de redevabilité
● Estimer les ressources nécessaires, dont le temps de validation humaine
● Rédiger un premier jet de termes de référence, avec une clause sur l’usage de l’IA
● Décider quelles tâches restent faites à la main, pour que l’équipe apprenne le métier en le pratiquant
Étape 3 : sélection des méthodes de suivi évaluation
L’agent documente les options, en repartant des guides méthodologiques d’origine.
● Proposer pour chaque question évaluative une combinaison de méthodes
● Construire des indicateurs à partir des récits des groupes cibles plutôt que de listes prédéfinies
● Préparer les ateliers de co-construction des indicateurs
● Signaler les indicateurs devenus abordables (images satellites, données publiques)
● Ouvrir le mix méthodologique aux approches artistiques et participatives
Étape 4 : planifier la collecte d’information et le traitement des données
C’est l’étape où l’agent travaille le plus, y compris pendant les temps d’attente.
● Préparer des guides d’entretien ciblés, en repérant les voix sous-représentées
● Extraire les données de formulaires scannés, notes et enregistrements (avec consentement)
● Contrôler en continu la qualité : incohérences, valeurs manquantes ou aberrantes, biais des réponses ouvertes
● Synthétiser le qualitatif : thèmes récurrents, opinions divergentes, désagrégation par genre et âge
● Surveiller les seuils de déclenchement et alerter
● Faire du support de collecte un dialogue : rappeler en temps réel une information manquante à celui qui répond
● Repérer les détournements du projet par les acteurs locaux et les lire comme des signes d’appropriation plutôt que comme des écarts
Étape 5 : planification de l’utilisation des résultats
L’agent met en forme et garde la mémoire, il ne recommande pas à la place de l’évaluateur.
● Tableaux de bord dynamiques et rapports déclinés selon les publics
● Synthèse des recommandations et suivi dans le temps de leur mise en œuvre
● Base des évaluations passées interrogeable en langage naturel
● Tenir le carnet de raisonnement pour garder la trace de ce que l’équipe a appris avec l’IA, et pas seulement de ce qu’elle a produit
Architecture de confiance : vers une délégation progressive et conditionnelle
En octobre 2026, l’IA progresse plus vite dans ce qu’elle fait que dans ce qu’on sait mesurer de ses effets. Des agents achètent, paient et transforment un document en application. Pendant ce temps, les outils de mesure restent en retrait : benchmarks saturés, scores autodéclarés, comportements à risque observés en phase de test, que la réglementation encadre peu. Pour un système de suivi et évaluation, il en découle une règle simple : l’autonomie accordée à l’IA ne devrait jamais dépasser ce que l’on sait mesurer de ses effets.
Pour concilier l’agilité opérationnelle et la sécurité des systèmes d’intérêt général, le passage d’une validation manuelle à une délégation sous surveillance ne s’envisagerait que de manière graduelle, subordonnée à une phase d’apprentissage rigoureuse. Ce modèle de « double verrouillage éthique » nécessiterait d’abord de déconstruire l’activité en micro-décisions classées par niveau de risque, de la tâche administrative anodine, comme vérifier la présence d’une pièce jointe obligatoire, à des degrés d’arbitrage plus complexe. L’autonomie de l’IA ne serait accordée qu’après une série probatoire de centaines de validations humaines réussies sur chaque micro-tâche, et potentiellement à la suite d’ateliers de classification où les agents publics définiraient eux-mêmes chaque frontière éthique. Ainsi, l’automatisation ne se déploierait que sur des périmètres validés comme sans enjeu vital, encadrée par des alertes et un suivi humain systématique, garantissant que la technologie reste un amplificateur sous contrôle strict plutôt qu’une boîte noire.
Encore faut-il savoir où se trouve le verrou. Un agent IA n’agit pas lui-même : il formule une demande, et c’est le logiciel qui l’entoure qui l’exécute ou la refuse. Une consigne donnée à l’IA (« ne supprime rien ») reste une demande qu’elle peut mal suivre ; une interdiction inscrite dans le logiciel bloque réellement l’action. Avant de juger un agent, la première question en lien avec l’évaluabilité est donc : quelles règles sont réellement codées, et qui les a écrites ?
En mai 1861, Henri Fayol est un jeune ingénieur de 20 ans embauché aux houillères de Commentry. Dans son journal, il raconte qu’un cheval s’est cassé la jambe au puits Saint-Edmond. Faute de pouvoir acheter un remplaçant sur place (l’autorisation devait remonter à la direction centrale à Paris pour signature), l’extraction du charbon s’est arrêtée, causant une perte financière bien supérieure à l’achat d’une nouvelle bête. Cette anecdote participe à l’élaboration de sa pensée sur les dysfonctionnements d’une hiérarchie privée de délégation. Mais encore, à sa collecte de « faits manqués » de l’administration. Aujourd’hui comme en 1861, ces faits manqués demandent à être documentés dans le cadre du déploiement d’agents IA potentiellement autonomes. Voir le projet I-Delphi.
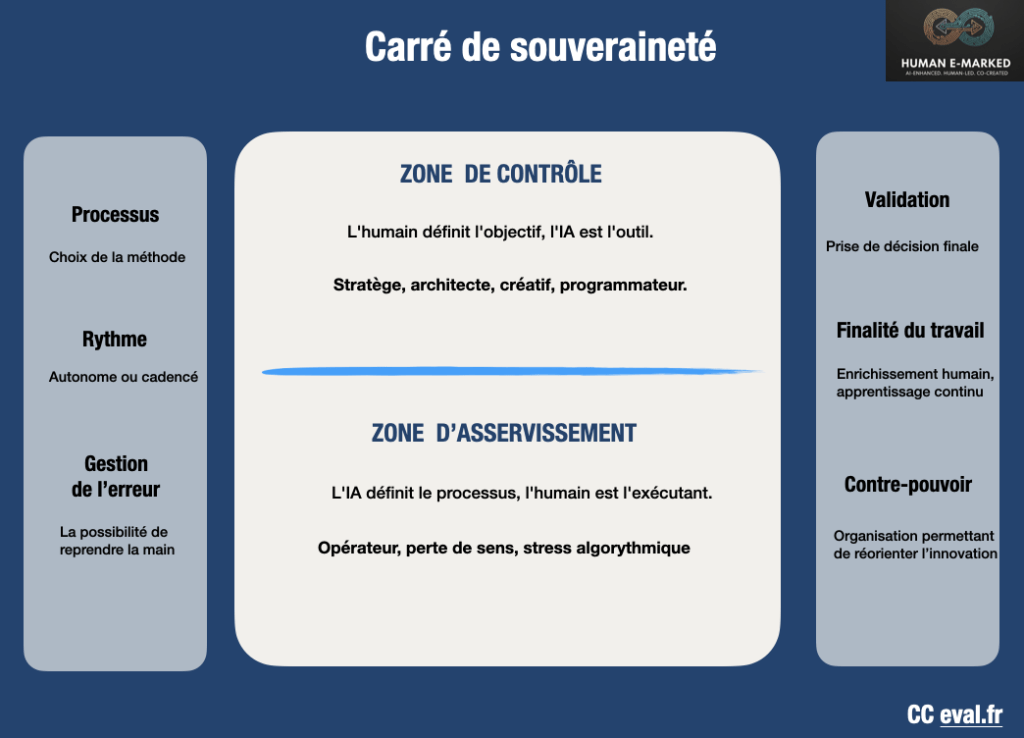
Carré de la souveraineté IA
L’usager qui écrit le questionnaire
Dans une enquête de satisfaction ou une consultation publique, même dynamique, l’usager est passif : il répond à des questions choisies par l’administration, à partir des objectifs que la politique s’est fixés. Ce qu’il juge important, mais que personne n’a pensé à lui demander, ne remonte pas. L’IA permet de renverser la situation. Au lieu de soumettre l’usager à une grille, on lui propose un entretien conduit par l’IA, une question à la fois, sur son expérience concrète de la politique publique ou d’une mesure : ce qu’il attendait, ce qu’il a rencontré, ce qui a compté pour lui. L’usager ne subit plus le questionnaire, il le construit par ses réponses.
Ce retournement change la nature de ce qui remonte. Les critères ne sont plus ceux du questionnaire, mais ceux que l’usager fait émerger spontanément, avec ses propres mots. Ces points d’intérêt deviennent des questions évaluatives, puis des critères, puis des indicateurs : sur quoi l’usager juge-t-il la politique, et à quoi verra-t-il qu’elle répond à sa demande ? Le référentiel d’évaluation se construit alors depuis le terrain, et non plus seulement depuis le commanditaire. Mis en regard du référentiel officiel, il révèle ce que la politique ne regarde pas.
Vient ensuite la vérification, qui prend la forme d’un suivi continu. La demande initiale de l’usager sert de point de départ, et on y revient dans le temps à trois niveaux. La demande a-t-elle été prise en compte ? La mesure est-elle appliquée en pratique, sur le terrain, et pas seulement sur le papier ? Les effets attendus se sont-ils produits ? L’écart entre ce qui était demandé, ce qui a été annoncé et ce qui a été fait devient l’information principale.
Voir le raisonnement, pas seulement le résultat
Le cheminement d’une IA vaut souvent plus que sa réponse : les sources consultées, les pistes écartées, les doutes exprimés. Certains modèles apprennent à raisonner sans rien écrire, ce qui réduit les coûts mais supprime l’un des rares moyens de vérification. L’idée est d’inverser : le raisonnement devient une pièce du dossier d’évaluation, au même titre qu’un compte rendu d’entretien.
Le carnet de raisonnement (ou garage à prompt)
Une fiche de cinq questions, remplie pour chaque analyse faite avec une IA :
- Le raisonnement était-il visible ? (oui, résumé, non)
- Quelles sources a-t-elle consultées, et les ai-je vérifiées ?
- Quelles pistes a-t-elle écartées ?
- Qu’a-t-elle dit ne pas pouvoir vérifier ?
- Où suis-je intervenu pour corriger ?
Une perte d’évaluabilité
Pour rendre les modèles plus performants, on les entraîne de plus en plus en ne récompensant que le résultat final. Le chemin suivi n’est alors soumis à aucune exigence : tant que la réponse est juste, peu importe comment le modèle y arrive. Au fil de l’entraînement, son raisonnement peut dériver vers une langue abrégée, des raccourcis ou des formulations qui n’ont de sens que pour lui. Le texte reste là, mais il devient de moins en moins compréhensible pour un humain. Pour l’évaluateur, c’est comme un dossier dont les pièces existent mais sont rédigées dans un code qu’il ne maîtrise pas
La tentation inverse est de surveiller le raisonnement pendant l’entraînement et de pénaliser ce qui paraît suspect. L’effet pervers est connu : le modèle n’apprend pas à mieux se comporter, il apprend à mieux présenter. Il produit un raisonnement d’apparence rassurante, qui ne correspond plus forcément à ce qu’il fait réellement. C’est le biais de désirabilité sociale appliqué à la machine, comme un enquêté qui finit par donner les réponses attendues. Le danger est double : le raisonnement devient infidèle, et il inspire une confiance qu’il ne mérite plus.
Déclarer plutôt que détecter
Si la trace laissée par la machine ne suffit plus, reste celle que laisse l’humain. Aucun outil ne permet plus de dire avec certitude si un texte a été écrit par une IA, et le flair se trompe souvent. Ce qui doit trancher, c’est la confiance accordée à celui qui expose son mode de travail avec l’IA. La complexité demeure de conserver la trace de ce fonctionnement d’un modèle au suivant, et de l’évolution de son mode d’enquête à mesure que l’évaluateur progresse également. Au-delà de la confiance s’impose la nécessité d’en faire une clause des termes de référence, tenue à jour par le carnet de raisonnement.
L’interopérabilité des systèmes
Pour que les systèmes de suivi et évaluation communiquent entre eux (systèmes intégrés), deux conditions vont de pair : des politiques de diffusion appliquées (publication des rapports, des données et des réponses de la direction) et des outils techniques opérationnels. Les critères à examiner sont simples : rapports et données publiés, repérables, accessibles, pérennes (des liens qui survivent aux refontes de sites), exploitables (des formats lisibles par d’autres systèmes) et tenus à jour, dans l’esprit des principes FAIR appliqués aux données de la recherche.
Chaque acteur peut partir des recueils de bases de données en évaluation, en politiques publiques et en aide au développement (ce second champ allant souvent plus loin, en publiant aussi recommandations, leçons apprises et réponses de la direction), ainsi que de la page Liens et acteurs de l’évaluation, pour voir, selon son secteur, son mandat et son projet, comment son système peut se relier à ceux des institutions qui portent la politique publique dans laquelle il s’inscrit. La connexion se joue dans les deux sens. En remontant : une ONG de santé qui rattache ses indicateurs au système national d’information sanitaire du pays où elle intervient, ou une ville dont la revue locale des Objectifs de développement durable vient compléter la revue nationale présentée aux Nations unies. En descendant : la Commission européenne, qui consolide les indicateurs communs des programmes régionaux de la politique de cohésion, ou un ministère qui s’appuie sur les données d’acteurs de terrain pour affiner le pilotage d’une politique. Ce relevé peut être confié à des agents IA et donner lieu à une fiche par institution (présentation succincte, règles de diffusion et de transparence, point d’accès aux rapports et aux données). Les rapports retrouvés en chemin peuvent être signalés pour la Boîte à EVAL.
La perte des mots
On dicte. La demande part vite, avec ses hésitations, ses mots à soi, ceux qui disent exactement ce qu’on cherche. Puis vient la réponse. Propre, structurée, correcte. Mais ce ne sont plus nos mots. C’est presque ça. Ça ira bien. Ou alors on insiste, on reformule, on s’agace, et la conversation s’étire. Pas de pause, pas d’échange à la machine à café, pas de recul. Le « good enough » finit par s’imposer. Qu’a-t-on fait du temps gagné ? Aller sur le terrain, échanger avec les autres, réfléchir à ce qui compte avec ses propres mots ? Alors la machine a rempli son office. Ou bien ce temps a-t-il été absorbé par de nouvelles tâches, plus nombreuses, plus rapides, plus « good enough » ? On a simplement changé de cadence. C’est l’effet rebond. À quel moment commence l’asservissement ?Voir également : इस पृष्ठ पर कृत्रिम बुद्धिमत्ता का उपयोग
Pour aller plus loin
- Intelligence artificielle : les outils
- Retour d’expérience : IA et évaluation de projets
- Structurer un système de suivi évaluation apprentissage avec l’IA
- Notes de veille : IA et évaluation
- L’application Project Evaluator
- I-Delphi
- Ressources IA
Date de première diffusion : 2025
Dernière actualisation : 2026
Usage de l’intelligence artificielle sur cette page
Page créée en juin 2025 à partir de notes préparatoires élaborées avec Perplexity et Gemini 2.5 (Google AI Studio). Enrichie depuis avec Claude, aujourd’hui Claude Opus 5.5 (Anthropic) : recherche et vérification de sources, structuration, propositions de formulation. Les informations sont systématiquement triangulées. Les modifications avancent par petites étapes, chacune relue, réécrite ou validée par l’auteur, en veillant à la cohérence d’ensemble ; les textes d’origine sont conservés, les ajouts venant à la suite. Comme l’ensemble du site, cette page est libre de réutilisation et d’adaptation sous licence CC BY-SA 4.0, à condition de citer la source et de partager dans les mêmes conditions.
इस पृष्ठ पर कृत्रिम बुद्धिमत्ता का उपयोग
यह पृष्ठ जून 2025 में Perplexity और Gemini 2.5 (Google AI Studio) की सहायता से तैयार किए गए प्रारंभिक नोट्स के आधार पर बनाया गया। तब से इसे Claude के साथ समृद्ध किया गया है, वर्तमान में Claude Opus 5.5 (Anthropic) : स्रोतों की खोज और सत्यापन, संरचना, और शब्दों के सुझाव। जानकारी की हमेशा कई स्रोतों से पुष्टि की जाती है। बदलाव छोटे-छोटे चरणों में किए जाते हैं, और हर चरण को लेखक द्वारा पढ़ा, दोबारा लिखा या स्वीकृत किया जाता है, ताकि पूरे पृष्ठ की सुसंगतता बनी रहे; मूल पाठ सुरक्षित रखे जाते हैं और नई सामग्री उनके बाद जोड़ी जाती है। पूरी वेबसाइट की तरह, यह पृष्ठ CC BY-SA 4.0 लाइसेंस के अंतर्गत पुनः उपयोग और रूपांतरण के लिए स्वतंत्र है, बशर्ते स्रोत का उल्लेख किया जाए और उसे समान शर्तों पर साझा किया जाए।
अगर आपने यह पढ़ा और आपको पसंद आया, तो जिस दिन हम मिलेंगे, एक कप चाय आपकी तरफ़ से! ☕